一句话结论:本地智能体缺的从来不是算力,是内存
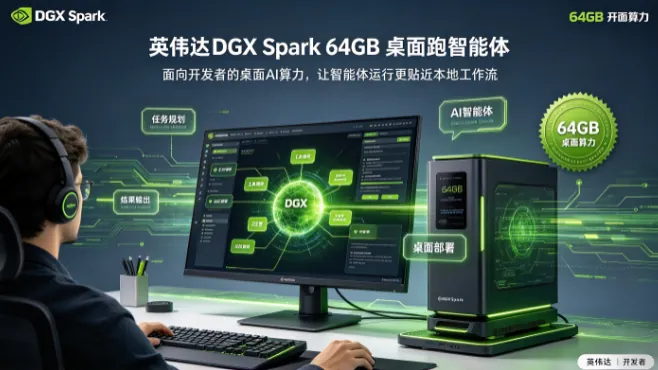
英伟达宣布 DGX Spark 将新增 64GB 统一内存版本,自 10 月 23 日起由宏碁、华硕、戴尔、技嘉、惠普与微星等厂商供货,出厂预装 DGX OS 与英伟达 AI 软件栈。据英伟达官方博客介绍,这套配置的目标是让开发者在本机运行可用的本地智能体,数据不出设备,也不依赖云端按令牌计费。
这则消息的价值不在参数表,而在于它把「本地跑得动」的门槛又往下压了一档。对一人公司这类没有机房、没有运维的团队,能不能在桌面上跑一个属于自己的智能体,直接决定数据主权和月度成本。
核心配置与关键指标
DGX Spark 采用 GB10 Grace Blackwell 超级芯片,FP4 精度下提供约 1 petaFLOP 的 AI 算力,每台内置 ConnectX-7 网卡。据英伟达官方博客介绍,新增的 64GB 统一内存配置可开箱运行 NVIDIA Agent Toolkit、CUDA-X AI 库、Nemotron 开放模型,以及 Ollama、vLLM 和搭配 CUDA 的 PyTorch 等常用运行时,从开机到跑起模型只需几分钟。
| 项目 | 规格说明 |
|---|---|
| 芯片 | GB10 Grace Blackwell 超级芯片 |
| 新增内存 | 64GB 统一内存版本 |
| 算力 | FP4 精度下约 1 petaFLOP |
| 联网 | 每台内置 ConnectX-7 网卡 |
| 供货时间 | 2026 年 10 月 23 日起 |
| 集群方式 | 两台经 QSFP 线缆直连,内存合计 128GB |
两台拼一台:集群设计才是真正的看点
据英伟达官方博客披露,两台 64GB 设备组成集群后,不只是内存翻倍。在英伟达对 Qwen 3.8 27B 的测试中,两台组成集群的 64GB 系统相比单台 128GB 系统,性能提升最高可达 1.7 倍,模型支持规模最高可扩展至 2000 亿参数。
配套的 NVIDIA Sync Cluster Assistant 会自动检测已连接设备、校验配置并设置 ConnectX-7 网络,每个节点运行相同软件栈,从单机扩展到双机不需要重新配置。按这个思路,采购节奏可以跟着业务走:先买一台,跑不动了再加一台,而不是一次性为峰值买单。
对一人公司的意义:三条现实变化
- 数据不出本机。合同、客户名单、私有语料放在自己桌面上处理,比放在第三方云上更容易向客户交代。
- 成本从月度订阅变成一次性投入。高频调用时,按令牌计费的账单一涨再涨,本地方案的上限是固定的。
- 可离线运转。断网环境下智能体仍能工作,对交付现场没有稳定网络的业务尤其关键。
需要说清楚边界:本地设备跑的是开放权重模型,能力与最前沿的闭源模型仍有差距。合理的组合是敏感数据与高频轻任务放本地,需要顶尖推理的少数环节走云端。
什么时候该上,什么时候先别急
如果每月在模型调用上的支出一路走高、客户对数据落地有明确要求、或者业务本身需要离线交付,这台设备值得排进采购表。如果调用量还很小、团队还在验证产品方向,先把流程跑通比先买硬件更重要。
采购前要算的三笔账
第一笔是功耗与占用。桌面级设备的耗电、噪音与散热条件都要考虑,普通工位未必适合长时间满载运行。设备面向的是开发者与本地智能体场景,实际使用强度决定它的性价比。
第二笔是对比云端的等价成本。把当前每月的模型调用费用、数据合规成本、断网造成的中断损失加在一起,再与一次性硬件投入加电力运维做对照,通常能算出一个清晰的临界点。
第三笔是团队能力。设备本身开箱可用,但要让本地模型稳定接入业务,仍需要有人懂提示词、懂上下文管理、懂评测。缺了这个角色,硬件只是昂贵的摆设。
更值得关注的一点:软件生态是否跟得上
硬件规格只是入场券。据英伟达官方博客介绍,DGX Spark 支持 NVIDIA Agent Toolkit、Nemotron 开放模型以及 Ollama、vLLM、搭配 CUDA 的 PyTorch 等常用运行时;本月底还将推出 NVIDIA Sync Model Launcher,用于一键下载并启动 Qwen3.8 27B,同时自动配置 OpenCode。
这套组合说明英伟达的目标不只是卖机器,而是让本地智能体有一条开箱可用的默认路径。对一人公司而言,真正的门槛往往不是算力,而是开机之后不知道拿它做什么。默认模板能否覆盖内容生产、数据处理、客户服务这些高频场景,决定了设备多久能回本。
一个务实的采购节奏
先用一台起步,把最容易受益的场景跑顺,再根据负载决定是否加第二台做集群。同时为云端保留接口:敏感数据与高频轻任务放本地,需要顶尖推理的少数环节走云端,两边的账分开算,比押注单一路径更稳。
常见问题(FAQ)
Q1:DGX Spark 64GB 和 128GB 版本冲突吗?
答:不冲突,是不同配置。64GB 是新增版本,侧重单机起步;两台 64GB 组成集群后内存合计 128GB,官方测试显示在 Qwen 3.8 27B 上相对单台 128GB 系统最高有 1.7 倍性能提升。
Q2:它能跑多大的模型?
答:据英伟达官方博客,单台可运行容纳于其内存的模型,双机集群后模型支持规模最高可扩展至 2000 亿参数。
Q3:买回来就能用吗?
答:开箱预装 DGX OS 与 AI 软件栈,支持常用运行时,官方称从开机到模型运行只需几分钟。本月底推出的 NVIDIA Sync Model Launcher 可一键下载并启动 Qwen3.8 27B,并自动配置 OpenCode。
参考来源
- NVIDIA 官方博客.《DGX Spark 64GB 为开发者提供更多构建本地 AI 的方式》2026
- NVIDIA 开发者博客.《在 DGX Spark 上运行本地智能体》2026
- NVIDIA 官网.《DGX Spark 产品页面》2026