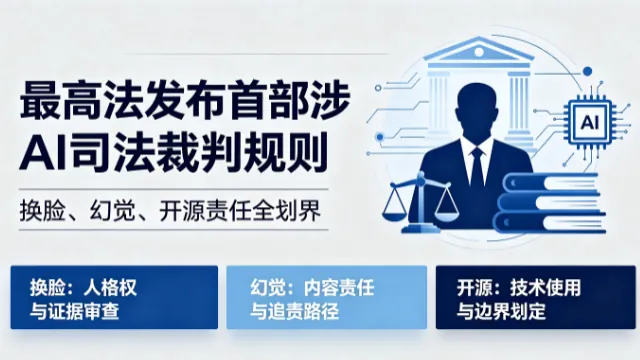
2026年9月7日,最高人民法院发布《关于依法审理涉人工智能纠纷案件的意见》(法发〔2026〕10号),全文共5部分24条。这是首部国家级涉AI司法裁判规则文件,把AI换脸、AI幻觉、大数据杀熟、开源软件责任等过去缺乏明确裁判依据的纠纷,一次性划出了审理口径,对每一位正在做AI产品的人都是必须读一遍的合规清单。
背景:AI跑得太快,裁判规则终于跟上
过去几年,AI应用大规模进入生产与生活,新型纠纷随之涌向法院:有人用AI换脸制作他人视频牟利,有人把他人声音拿去训练模型,有人因模型输出错误信息造成损失,还有开发者因使用开源代码被告上法庭。由于缺乏针对性的规则,这类案件在不同法院可能得出不同结论,当事人无法预判风险,企业也难以建立稳定的合规预期。
此次意见的发布,正是为了填补这一空白。作为首部国家级涉AI司法裁判规则文件,它并不创设新的法律,而是把现有法律体系在AI场景下的适用方式讲清楚,让法院在审理涉AI案件时有统一尺度,也让从业者知道自己行为的边界在哪里。对AI创业者来说,规则的明确本身就是一种红利:不确定性消失了,合规成本从“猜”变成“算”。
细节:五类最容易踩线的场景被逐一点名
人格权益是本次规则的第一个重点。意见明确,未经同意使用AI处理他人姓名、肖像,生成可识别的虚拟形象,构成对人格权益的侵害;未经同意使用自然人声音作为训练语料,同样构成对声音权益的侵害。这意味着AI换脸、拟声产品在采集与使用素材时必须取得明确授权,哪怕素材来自公开渠道,用于训练与用于生成可识别形象是两回事。
数据使用规则同样给出明确信号。意见规定,在合理范围内处理已合法公开的个人信息,且个人未明确拒绝的,一般不认定侵权。这为AI训练数据的使用留出了合法空间,同时也提示从业者:公开不等于可以任意使用,合理范围与个人拒绝权仍是不可忽视的边界,数据合规制度必须从创业第一天就建立。
针对AI幻觉问题,意见为“模型乱说话造成损失谁担责”提供了裁判框架,输出不实信息侵害他人权益的案件不再无法可依。针对大数据杀熟,意见重申算法不得对消费者实施不合理的差别待遇。针对开源软件,意见对开源软件的法律责任作出专门规定——这对依赖开源模型的AI创业者尤为关键,选用开源模型、开源组件不等于免责,许可证义务与合规审查需要纳入日常工程流程。
影响:合规正成为AI产品的基础架构
对AI公司而言,这套规则的实际影响是深远的。产品层面,换脸拟声功能需要从技术上预留授权校验与拒绝机制;数据层面,训练语料的来源与使用要留下可审计记录;内容层面,面向用户的生成结果需要具备可追溯性,避免AI幻觉引发的责任落到自己头上。合规不再只是法务部门的事,而是产品、算法、数据团队的共同约束条件。
对开源社区与个人开发者来说,意见带来的信号偏向积极:合理使用公开数据有章可循,开源软件责任边界被专门澄清,小团队不必为模糊地带过度恐慌,但也不能再以“不知道规则”为由踩线。法律给了明确的河床,水流反而会更顺畅。
具体落地时,建议创业团队建立三层合规动作:训练数据层,为语料来源留痕,公开数据使用前评估是否涉及个人可识别信息;产品功能层,为换脸拟声类功能设置授权校验,为生成内容增加溯源与风险提示,对高风险输出安排人工复核;开源依赖层,建立许可证清单,定期审查所用开源模型与组件的义务条款。规则不会束缚创新,只会淘汰那些把违规当捷径的产品。
站在全球视角,此次意见也是AI治理规则竞赛的一部分。欧美围绕AI责任与版权已有多轮立法与判例博弈,中国选择以司法解释的方式在司法层面率先给出裁判口径,路径务实且可操作。对出海与在国内经营并重的AI团队而言,这意味着要同时对照多套规则体系设计产品,合规能力本身正成为跨国竞争的入场券。
对创业者与一人公司,这份意见应当被当作产品需求文档来读:把合规条款翻译成功能清单,例如授权提示、数据来源声明、内容溯源标识、用户拒绝通道。谁先把合规做成产品体验的一部分,谁就能在客户信任与渠道准入上领先一步。规则已经划好,剩下的功课是如何在边界内把AI做得更有价值。边界清晰之后,敢在文档与产品说明里把合规机制写清楚的小团队,反而更容易赢得企业客户的信任,把规则红利变成实在的销售语言。
*本文仅代表作者个人观点(仅供参考)* 来源:创客OPC原创整理