一句话结论:权重开放正在改写 AI 产业链的分工方式
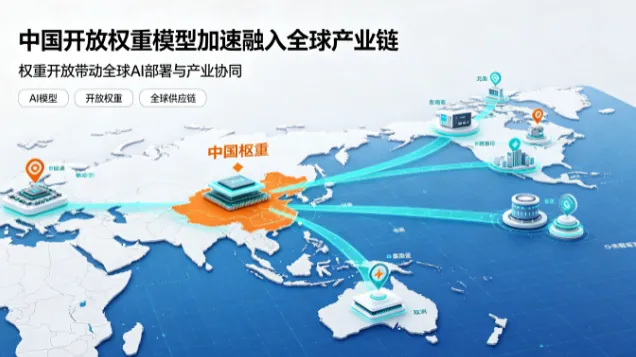
据《人民日报海外版》2026 年 9 月的报道,中国开放权重模型正在加速融入全球人工智能产业链:以 Kimi、DeepSeek 为代表的开源模型,其架构与权重被海外团队用作后训练底座,部分海外 AI 应用公司在成本压力下转向这些模型构建产品。
这条信息的价值在于它描述的不是"谁的模型更强",而是"产业链的钱怎么流"。当模型权重可以被下载、被修改、被私有部署,模型本身就不再是稀缺资源,稀缺的变成三样东西:把模型接进业务的能力、干净的数据、以及能持续获客的场景。
二、开放权重这条路,今年发生了哪些实质变化
国内侧:开源节奏与成本下降同时发生
| 时间 | 事件 | 关键信息 |
|---|---|---|
| 2026 年 9 月 | DeepSeek V4.1-Flash 发布 | 开源方案,KV 缓存占用降至原来的约四分之一,长上下文成本下降 |
| 2026 年 9 月 | GLM-5.3-Flash 开源 | 约 320B 规模,官方口径以约七分之一成本逼近更大模型 |
| 2026 年 9 月 | 阿里预览 Qwen3.8-Flash-Next 与 Qwen4 | 继续扩大开放权重的模型谱系 |
三个动作指向同一条曲线:单位智能的成本在快速下移。对使用者来说,这意味着去年因为成本无法成立的产品方案,今年可以重新算一遍账。
海外侧:开放权重被当作降本工具使用
报道提到,部分美国 AI 公司因成本压力转向中国开放权重模型,并用其架构做后训练。这个现象的技术前提很朴素:MIT 或 Apache 类许可允许修改与商用,团队可以在自己手里完成微调与部署,不必把长期成本绑在某一家的定价表上。
三、对一人公司的真实影响:把"可选项"变成"必选项"
影响一:成本从"越用越贵"变成"越用越稳"
按调用量计费的闭源 API,成本随业务量线性上升。私有部署的开放权重模型,前期有硬件与调试投入,之后边际成本接近于零。对月调用量稳定的业务,这是一次成本结构的切换;对流量波动大的业务,则要权衡闲置算力的浪费。
影响二:数据不出门,某些生意才做得成
涉及客户资料、内部文档、病历或合同类内容的场景,把数据送到第三方接口往往是合作谈不下去的第一道坎。开放权重模型可以部署在自有服务器或本地设备上,这是很多垂直行业项目能够落地的前提。
影响三:停服与改价的风险被剥离
依赖单一闭源接口的产品,最怕两件事:接口涨价与模型下线。使用开放权重时,只要权重文件在手,供应商的商务策略变化不会直接导致产品停摆。对把交付写进合同的一人公司,这是实打实的风险对冲。
四、选型账:什么情况选开放权重,什么情况选闭源 API
| 判断维度 | 更适合开放权重 | 更适合闭源 API |
|---|---|---|
| 调用量 | 稳定且处于中高水位 | 波动大、总量低 |
| 数据敏感度 | 高,不能出内网 | 低,可接受第三方处理 |
| 技术能力 | 具备基本的部署与运维能力 | 无运维资源,求开箱即用 |
| 能力要求 | 通用任务为主,可接受调试 | 需要顶级推理与最新能力 |
| 长期成本 | 关注三年以上的总持有成本 | 关注前期零投入 |
这张表的用法很简单:先看数据敏感度和调用量,再看自己的技术能力。三者都指向开放权重时,才值得投入部署成本;否则先用闭源接口验证业务,跑通之后再迁移,是更省钱的顺序。
五、一人公司的三步落地
第一步,把业务拆成"能本地跑的"和"必须用云端的"。 大多数一人公司业务可以拆成两类:重复性的信息处理(分类、摘要、格式化、对话应答)适合本地模型;需要前沿推理能力的关键环节留给闭源接口。混着用,成本最优。
第二步,先做一份离线评测。 不要凭印象判断"小模型够不够用"。挑 30 至 50 条自己业务的真实样本,在同一套提示词下对比两三个候选模型,记录准确率与人工返工比例。这份评测结果,比任何榜单都有参考价值。
第三步,把部署成本摊到合同里。 如果私有部署是为了满足客户的数据要求,这笔硬件与调试投入应当体现在报价中,而不是自己默默承担。一人公司最常见的财务错误,就是把"为了签单不得不做"的成本,算成"技术投入"。
FAQ 常见问题
Q1:开放权重模型和开源模型是一回事吗?
不完全是同一层概念。开放权重指模型参数可以被下载使用,但训练数据与流程未必公开;开源模型的范围通常更大,包含训练代码、数据处理流程等。商用前需要逐项核对许可证条款。
Q2:一人公司自己部署模型,成本大概是什么量级?
成本主要由硬件、电力和调试工时构成。量化后的小参数模型可以在消费级显卡甚至 CPU 上运行,适合分类、摘要这类任务;需要更大参数模型的场景,则要考虑租用算力或采购设备。具体量级取决于模型大小与并发要求,建议先用离线评测确定所需规模。
Q3:用开放权重会不会影响输出质量?
取决于任务类型。结构化信息抽取、分类、摘要等任务,中小模型的表现已经很接近大模型;复杂推理、长链条任务仍是闭源旗舰的优势区间。混用是按性价比最高的方案。
Q4:把模型部署在内网,一定更安全吗?
不一定。私有部署解决的是"数据不出门",但部署环境本身的访问控制、日志、备份同样重要。安全取决于整体方案,而不是单靠部署位置。
总结
中国开放权重模型融入全球产业链这件事,对一人公司的实际含义是:单位智能的价格正在下移,而且这个下移是可获取的——权重能下载,成本能自己算。选型的正确顺序是先验证业务,再优化成本;先把数据敏感度和调用量算清楚,再决定要不要自建。行动建议:本周挑三五十条真实样本,做一次离线评测,用数据替代印象。
参考来源
[1] 人民日报海外版.中国开放权重模型融入全球 AI 产业链相关报道.2026
[2] DeepSeek.DeepSeek V4.1-Flash 发布说明.2026
*本文仅代表作者个人观点(仅供参考)* 来源:创客OPC原创整理