一、先把事实摆齐:这笔钱到底买了什么
当地时间 9 月 28 日,AMD 发布官方公告:以约 82 亿美元(折合人民币约 550 亿元)的全股票交易,收购由「AI 教母」李飞飞创办的 AI 实验室 World Labs。交易预计 2026 年底前完成,仍需监管批准。完成后,李飞飞出任 AMD 执行副总裁兼首席科学家,直接向 CEO 苏姿丰汇报。
82 亿美元 交易额,AMD 史上第二大收购(仅次于 2022 年 500 亿美元买赛灵思) | 约 70 人 World Labs 团队规模,含 2026 年 7 月收购的机器人仿真公司 SceniX | 12 亿美元+ World Labs 累计融资,2026 年 2 月那轮就融了 10 亿 |
World Labs 2024 年初成立,创始人除了李飞飞,还有神经辐射场(NeRF)论文作者 Ben Mildenhall、以及 Justin Johnson。它做的叫「空间智能」和「大世界模型(LWM)」:让 AI 理解三维世界,能生成、重建、模拟可交互的三维环境。2025 年底推出 Marble,2026 年 9 月 1 日发布新一代模型 Atlas,原生支持文字、图像、视频和 3D 数据,在一个统一的空间上下文里生成和模拟三维世界。
一个有意思的细节:AMD 本来就是 World Labs 的投资方。2026 年 2 月那轮 10 亿美元融资,Autodesk 领投,AMD、英伟达、富达(Fidelity)参投。也就是说,从「投资人」到「全资收购方」,AMD 只用了不到八个月。
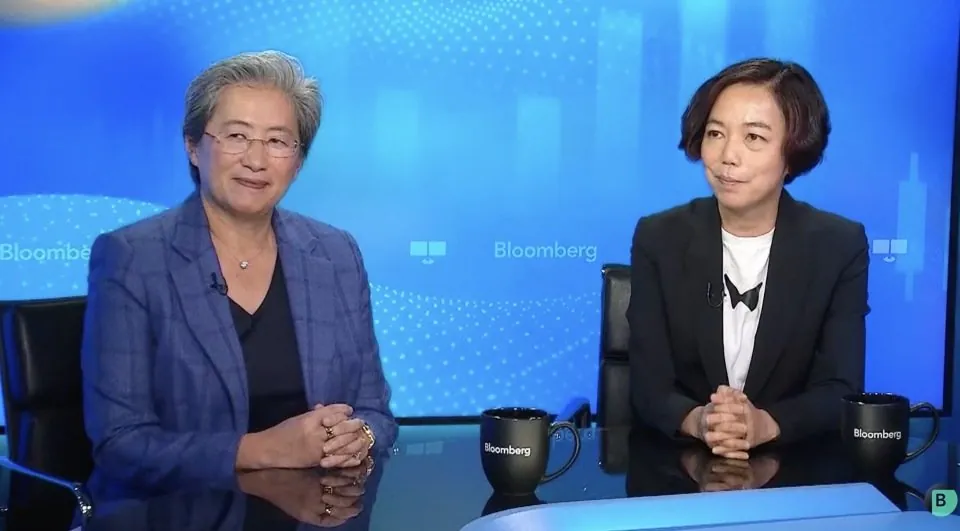
AMD CEO 苏姿丰与李飞飞联名宣布收购 World Labs。李飞飞将加入 AMD 任执行副总裁兼首席科学家。图源腾讯新闻原文配图。
二、第一课:巨头买的是「工作负载的定义权」,不是模型
表面看,AMD 花 82 亿买了一个 70 人的实验室。但苏姿丰在彭博社采访里说透了逻辑:「你对端到端流程了解得越深,就越能造出更好的系统。」AMD 买的,是提前接入最前沿「空间重构与物理仿真算法」的门票,好用来指导下一代 GPU 和 CPU 怎么设计。
传统芯片路线图只盯着通用的矩阵运算和吞吐量。把 World Labs 收进来之后,AMD 能在硬件研发早期就拿到物理 AI 对内存带宽、延迟、计算单元的精确需求。这叫软硬件协同演化(co-design),在芯片行业里是实打实的护城河。
一张牌桌的真相:算力巨头正在把「模型实验室」当成下一代算力的需求探针。谁定义了未来的工作负载,谁就定义了未来的芯片。
把时间线拉出来看,这分明是西方芯片巨头的一条固定打法:用并购把「最前沿的模型层」买进来,反向喂养硬件设计。它并非偶然,也非孤例。
| 公司 | 被收购方 | 金额 / 时间 | 买的是什么 |
|---|---|---|---|
| AMD | ATI(显卡) | 54 亿美元 / 2006 | 图形与 3D 软件,奠定 APU 根基 |
| AMD | 赛灵思 Xilinx(FPGA) | 约 500 亿美元 / 2022 | 自适应计算,史上最大收购 |
| AMD | Pensando(DPU) | 19 亿美元 / 2022 | 数据中心网络与卸载 |
| AMD | Silo AI(芬兰 AI 实验室) | 6.65 亿美元 / 2024 | AI 软件与人才 |
| AMD | ZT Systems(AI 服务器) | 49 亿美元 / 2024 | 整机系统能力 |
| AMD | World Labs | 82 亿美元 / 2026 | 空间智能与世界模型 |
| 英伟达 | 迈络思 Mellanox | 约 70 亿美元 / 2019 | 高速互联,奠定算力集群底座 |
| 英伟达 | Groq 资产 | 约 200 亿美元 / 2025 末 | 推理芯片,史上最大收购 |
| 英伟达 | Hugging Face | 129 亿美元 / 2026.9 | 开源模型分发入口与开发者关系 |
给创业者的第一个判断:底层算力这张牌桌,普通人上不去,也别去上。真正值得抢的,是「定义新工作负载」那张牌桌,也就是在某个具体的物理场景里,率先把模型和真实需求咬合到一起。
三、第二课:国内国外的「买法」根本是两套算法
同一笔「芯片巨头买 AI 模型公司」,放在国外和国内,玩法完全不一样。看懂这个差别,比看懂价格本身更重要。
国外算法:资本自由流动,IP 自由买卖
在西方,并购是主流卡位手段。钱、团队、专利都能议价成交。英伟达买 Hugging Face 之后第一句话就是「不强制用英伟达算力、保持开放」,因为它买的是开发者关系与分发入口,逼人站队反而会把社区吓跑。这种「先承诺不绑定」的话术,恰恰说明它买的资产价值在于「中立信任」。
国内算法:买不到西方硅,就只能自己造;同时反垄断是一道真闸门
中国买不到先进制程的西方芯片,受出口管制所限,自研自造是唯一的路。华为昇腾 950PR(2026 年 3 月)、CloudMatrix 384 超节点(384 颗昇腾组一柜)、DeepSeek-V4 在发布当日就完成昇腾平台「Day 0」适配,都是这条路的产物。
另一道闸门是反垄断。英伟达 2020 年收购迈络思(Mellanox),中国市场监督总局是「附加限制性条件批准」,要求继续公平供货。也正是这个条件,让英伟达在 2024 到 2026 年连续被立案、被进一步调查。高通当年想 440 亿美元买恩智浦(NXP)被否,也是前车之鉴。换言之,AMD 这笔 82 亿美元交易,只要想动中国市场的收入,同样得过中国监管这一关。
更有意思的是,中国自己的「世界模型 / 空间智能」创业潮,正在复刻一条平行赛道,而且已经拿到真金白银:
| 国内公司 | 方向 | 进展 |
|---|---|---|
| VAST 三启万物 | 3D 原生基础模型 + 世界模型 | 不到半年累计融资约 50 亿元,刷新 3D 原生智能融资纪录;Tripo P2.0 已接入网易、酷家乐、拓竹 |
| 流形空间 Manifold | 原生 3D 世界模型 | 累计融资约 10 亿元,WorldScape 支持单图生成可交互空间,对标 World Labs |
| 影溯 InSpatio | 原生 3D 世界模型 | 数千万美元 Pre-A,由光合创投、顺为资本、红杉中国联合参投 |
| 魔芯 Moxing | 4D 世界模型 | 估值 15 亿美元,MoWorld 4D 全跑在华为昇腾 NPU 上,50 帧/秒实时推理,成本仅 GPU 方案 30%,获华为哈勃投资 |
把魔芯和 World Labs 放一起看,会发现国内外的「对标」已经明确:一边是李飞飞把公司卖给 AMD,另一边是魔芯把模型「绑死」在华为昇腾上、用国产算力把成本砍掉七成。对国内创业者来说,这是一条西方巨头既买不到、也抄不走的「主权位置」。
中国的芯片整合已经开场。业内已有华为收购壁仞(Biren)部分资产(约 5 至 8 亿美元,以专利和 IP 为主)的传闻。国内版的「AMD 买 World Labs」剧本,正在用另一种方式上演。
四、第三课:李飞飞走过的,是一条「技术人创业被收编」的标准路径
这笔交易最值得普通创业者反复琢磨的,是李飞飞走过的路径,金额反倒是次要的。它几乎是一份可复制的模板:
第 1 步:选一个巨头刚需、但还没被定义清楚的命题
李飞飞有个判断很出名:宇宙由真实事物构成,而不是由文字构成。当所有人都在卷大语言模型,她押的是物理世界的空间智能,正好卡在 AMD、英伟达都想抢占的下一站。
第 2 步:组一支精悍的精英小队
约 70 人,核心来自斯坦福、NeRF 原班人马、机器人仿真团队。不铺人头,只拼密度。小团队也能造出被巨头估值 82 亿的资产。
第 3 步:先出真东西,再谈估值
Marble、Atlas 不是 PPT,是能用的模型。能被收购的前提,是已经证明了技术拐点的存在。
第 4 步:先拿战略投资方,再被收编
AMD、英伟达同时是它股东。这等于提前把「买家」请进了董事会,退出路径从第一天就写好了。
你不必去造下一个英伟达。你可以去造那个英伟达、AMD 会想买的东西。
这对一人公司(OPC)尤其有启发:用「巨人盲区策略」在巨头看不上、但适合单兵作战的高毛利垂直缝隙里,把自己经营成一份「可收购资产」,比硬刚底层更有胜算。
五、重新看 AI 架构:主战场从「语言」挪到了「物理与空间」
World Labs 的空间智能路线:把生成式模型与物理几何结合,从二维图像预测三维世界。图源腾讯新闻原文配图。
过去三年,AI 的主战场是语言:谁的参数多、谁会聊天,谁就赢。这笔收购释放了一个清晰信号,战场正在从「语言模型」转向「物理与空间智能」。
- 范式变了。世界模型把「生成式」与「物理几何」拧在一起。李飞飞的判断很直白:宇宙由真实事物构成,而不是由文字构成。它要懂遮挡、懂重力、懂一个杯子掉下桌子会碎。大语言模型预测下一个词,世界模型预测下一个视角、下一种物理状态。
- 瓶颈迁移了。过去卡在算力与参数,现在卡在三件事:物理数据的稀缺、空间计算对内存带宽和延迟的极度渴求、以及能精确模拟现实的模型带来的「对齐与安全」难题。李飞飞在采访里明确说,模型对齐是和性能同等重要的一等公民。
- 具身智能要先在数字世界演练。World Labs 收购 SceniX 做机器人仿真,逻辑就在这里:让机器人和自动化系统进真实世界之前,先在数字空间里把策略跑熟。
对创业者的含义很直接:语言类应用已经卷成红海,但「让 AI 理解并操作三维物理世界」这条线,才刚刚开始,缝隙一大把。
六、重新看 CPU 架构:芯片要为「物理 AI」重新长一遍
AMD 正把模型层需求喂进下一代硬件:EPYC 与 Instinct 协同,CPU 与 GPU 越绑越紧。图源腾讯新闻原文配图。
AMD 的协同演化思路,会直接改写接下来两年的 CPU 与加速器架构。把公开路线图摊开看:
| 时间 | 产品 | 关键点 |
|---|---|---|
| 2026 | EPYC Venice(Zen 6) | 台积电 2nm,最高 256 核,内存带宽冲到 1.6 TB/s,PCIe 6.0 把 CPU 到 GPU 的带宽翻倍 |
| 2026 | Instinct MI400(CDNA 5) | HBM4 显存 432GB,带宽 23.3 TB/s,40 PFLOPS(MXFP4),组成 Helios 机柜(72 颗 + Venice + Pensando 800Gb/s 网卡,用 UALink 互联) |
| 2027 | EPYC Verano(Zen 7) | 继续年度刷新节奏,强化能效与互联 |
| 2027 | Instinct MI500(CDNA 6) | 下一代机架级 AI 系统底座 |
几条清晰的趋势:chiplet(小芯片)与 3D 堆叠继续推进,异构整合开始专门为空间与仿真负载调优;CPU 和 GPU 不再各管各的,而是越绑越紧;CPU 在边缘具身、低延迟推理里的角色会继续变大。
中国这边是平行答卷:华为昇腾 950PR 加 CloudMatrix 384(384 颗 910C / 950 组一柜)直接对标英伟达 GB200,全跑在国产中芯 7nm 产线上(良率约 20% 到 40%)。魔芯的 MoWorld 已经证明,世界模型跑在昇腾上、成本只要同规模 GPU 的三成,这条路在国产算力上走得通。
未来几年,芯片真正的胜负手,是看谁的硬件最懂「物理 AI」的工作负载,晶体管数量不再是唯一标尺。
七、给一人公司(OPC)的三条可落手建议
1. 别上底层牌桌,去上层做垂直空间 AI
造芯片、训基础大模型,是巨头和国家的牌桌。属于单兵的缝隙在应用层:机器人仿真、数字孪生、室内设计 3D、电商 3D、影视预演、工业巡检。挑一个你懂行业的垂直场景,把世界模型当水电用,比从零造模型强得多。
2. 用「绑定国产算力」造护城河
魔芯跑通了「世界模型 + 华为昇腾,成本砍七成」。国内世界模型公司已经验证这条路可行。对创业者来说,把产品深度适配国产算力栈(昇腾 CANN、飞腾、寒武纪),既拿到政策与成本红利,也造出一个西方巨头抄不走的位置。
3. 把公司当成「可收购资产」来经营
李飞飞给的模板很具体:选巨头需要的命题、出真东西、先拿战略投资、等被收编或被集成。哪怕是个人或小团队,也可以照这个逻辑卡位,让自己成为某条产业链上「巨头会想买的那一块」。
八、结尾
82 亿美元买下的,不只是一个实验室,而是「算力巨头 + 物理世界 AI」的一张新入场券。看懂这张票的玩法,比看懂价格本身更重要。
对普通人、对一人公司来说,这张票的真正启示就一句话:底层在被巨头重写,但上层的垂直缝隙正在被重新打开。别去抢造芯片的锄头,去挖那些巨头还没顾上挖的金子。
① 本文由「创客极点 · OPC 实战」基于公开报道二次创作,事实与数据来自腾讯新闻、路透社、AMD 官方公告、中国金融信息网、华为百科等公开渠道,并经多源交叉核对;
② 文中配图取自上述公开报道原文配图(腾讯新闻),已内联嵌入,版权归原作者所有,仅作评论引用;
③ 转载请保留本声明与出处(xoyo168.com),商业用途请先联系授权。
*本文仅代表作者个人观点(仅供参考)* 来源:创客OPC原创整理