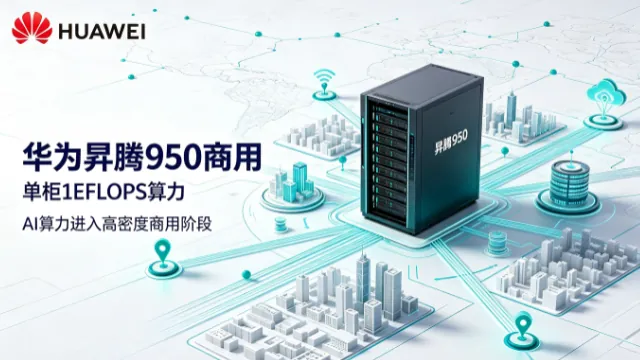
结论先行:华为在 2026 年全联接大会(HUAWEI CONNECT)期间推进 Atlas 950 SuperPoD 商用落地,单柜集成 1024 张加速卡,FP8 精度下提供 1 EFLOPS 算力,配备 256TB 全局统一内存,跨柜往返时延压缩至 3 微秒,满配可扩展至 8192 卡。用一句话概括这批参数的含义:一台机柜的算力规格,已经对齐过去若干机房才能凑出的规模,超大算力的获取方式正在从申请云端额度,转向采购一台标准设备。
本届大会于 9 月 17 日至 19 日在上海举行,英文主题确定为 ADVANCING THE AGENTIC WORLD,把智能体(AI Agent)的规模化落地写进主线议题。据今日头条《AI 模型榜单日报》整理的现场信息,Atlas 950 SuperPoD 的核心指标集中在三处:算力密度、内存规模与互联时延。
1 EFLOPS 的量级:单柜算力如何换算成业务吞吐
结论:算力密度提升的直接意义是单位空间可承载的模型规模变大,而不是单纯的跑分变高。EFLOPS 是每秒百亿亿次浮点运算的单位,FP8 作为低精度计算格式,被主流芯片用于推理加速与部分训练环节,能够在相近的功耗与芯片面积下换取更高的有效吞吐。1024 张卡集中在一个机柜之内,意味着节点之间不必跨越机房布线与多层网络交换,多卡协同的数据往返路径被大幅压缩。
对模型团队而言,可感知的变化集中在三件事:可训练的参数规模上限、同等任务所需的墙钟时间、以及推理服务的单位成本。算力密度越高,单次实验的等待时间越短,一个季度内能完成的迭代轮数就越多;迭代轮数越多,团队在相同周期内能验证的技术路线就越丰富。这是硬件指标与研发节奏之间最实际的一条传导链,也是整柜级产品被反复强调算力密度的原因。
还有一个容易被忽略的变量是能耗与部署空间。同样是千卡量级,机柜内部互联替代跨机房组网,可以省下大量交换设备、光模块与配套制冷投入,机房面积与电力申报的复杂度同步下降。对自建算力的大中型团队,这部分隐性成本往往与芯片采购价处于同一量级。
256TB 全局统一内存与 3 微秒时延:互联才是可用算力的天花板
结论:大规模并行计算的瓶颈常常不在单卡算力,而在数据搬运。256TB 全局统一内存的设计目标,是让多张卡在逻辑上共享同一片可寻址的内存空间,减少显式切分、重复拷贝与内存冗余带来的开销;跨柜往返时延压缩到 3 微秒,则直接关系到流水线并行、专家并行等策略的通信效率。
推理侧的收益更直观。混合专家(MoE,Mixture of Experts)架构依靠稀疏激活降低单次计算量,代价是把压力转移到专家之间的数据交换上;时延越低、内存越快,稀疏化带来的理论收益才越容易兑现为真实吞吐。这也是近期多款旗舰模型一边扩大总参数、一边严格控制激活参数的原因,硬件侧的互联能力决定这条路线能走多远。
训练侧的逻辑类似。万亿参数级模型的并行训练需要频繁同步梯度与中间激活值,通信开销会随卡数呈非线性增长。满配可扩展至 8192 卡的集群能力,让机柜可以作为积木式单元继续叠加,团队按规模分阶段扩容,不必一次性规划完整的超大规模集群。
参数与能力对照表
| 指标 | Atlas 950 SuperPoD 规格 | 对应影响 |
|---|---|---|
| 单柜加速卡数量 | 1024 张 | 节点高度集中,减少跨机柜组网层级 |
| 算力(FP8) | 1 EFLOPS | 支撑万亿参数模型的高强度计算 |
| 全局统一内存 | 256TB | 降低多卡之间的数据切分与拷贝开销 |
| 跨柜往返时延 | 3 微秒 | 提升流水线并行与专家并行的通信效率 |
| 满配扩展规模 | 8192 卡 | 按机柜单元横向堆叠扩容 |
| 外部采购动向 | 境外媒体报道 DeepSeek 计划采购至少 16 万颗昇腾 950DT | 反映推理侧对国产算力的规模化需求 |
采购动向背后的信号:推理需求正在主导算力结构
结论:比单项参数更值得看的是算力需求的结构变化。据今日头条《AI 模型榜单日报》援引境外媒体报道,DeepSeek 计划向华为采购至少 16 万颗昇腾 950DT。一个模型团队一次性规划十几万颗加速器的采购量级,指向的是长期在线服务而非一次性训练——推理是持续消耗,训练是阶段性消耗,两者的采购逻辑、成本模型与硬件偏好完全不同。
推理侧的算力规划有三个特征:需求随用户量增长而累积、对单位成本与能效极为敏感、对时延与稳定性要求高。这恰好与高密度整柜、低时延互联、大统一内存的产品方向吻合。当调用量成为收入的主要来源,算力预算的评判标准就会从峰值跑分转向每百万 Token 的落地成本,采购决策也随之从技术指标对比变成财务模型测算。
国产算力进入规模采购序列,还带来一层供应链意义:供给来源多元化会提高采购议价空间,降低单一路径的交付风险。对需要长期在线服务的团队来说,成本可预期比短期的性能峰值更重要,因为收入是按月结算的,算力支出同样是按月发生的。
对超级个体与小型团队意味着什么
结论:整柜级产品不会直接卖给个人,但它会改变个人能用到什么。算力供给大致分为三层:超大规模集群、整柜级一体机、以及通过云平台租用的弹性额度。前两层的密度与能效提升,最终会压低第三层的单位价格,并让中长上下文、多模态、智能体长链路执行这类高消耗任务变得可负担。
一人公司(OPC,One Person Company)与超级个体的典型负载是高频小批量:客服自动回复、内容批量生成、数据抓取与清洗、多智能体工作流编排。这类负载对绝对算力要求不高,但对单位成本极其敏感。当底层算力成本持续下行,个人与小型团队可以把更多预算放在垂直领域知识、专有数据积累与产品验证上,这比追逐参数规模更接近可持续的竞争壁垒。
反过来看,硬件规格的跃升也会改变产品设计的边界。过去因成本被排除在外的功能,例如长文档全量理解、视频级多模态处理、智能体长时间自主执行,会随着单位算价下降重新进入可行区间。对独立开发者而言,判断一项能力是否值得投入,除了技术可行性,还要看它的单次调用成本能否被自身的收入模型覆盖。
常见问题(FAQ)
Atlas 950 SuperPoD 的 1 EFLOPS 是什么精度下的算力?
1 EFLOPS 对应 FP8 精度。FP8 是当前主流的低精度计算格式,常用于推理加速和部分训练环节,能在相近硬件条件下提供更高的有效吞吐。
256TB 全局统一内存解决了什么问题?
它让单柜内的多张加速卡在逻辑上共享统一可寻址的内存空间,减少数据在多卡之间反复切分、搬运与拷贝的开销,对大模型并行计算尤为关键。
3 微秒跨柜时延对训练和推理的影响有多大?
时延决定多卡通信效率。流水线并行、专家并行等策略需要频繁交换中间结果,通信越快,稀疏激活等设计带来的理论收益越容易转化为真实吞吐。
个人开发者能直接买到这种整柜设备吗?
整柜级产品通常面向企业与机构交付。个人与小型团队更现实的路径是通过云平台按需租用算力,硬件侧的密度与能效提升会逐步传导为更低的租用价格。
国产算力供给增加对 AI 创业的成本结构有什么影响?
供给多元化会增加采购议价空间,并降低交付不确定性。对创业团队而言,最大的受益是长期成本变得可预期,可以把预算更多投向垂直数据与产品验证环节。
参考来源
- [1] 今日头条.《AI 模型榜单日报》2026
- [2] 华为.《HUAWEI CONNECT 2026 大会信息》2026
- [3] 腾讯研究院.《AI 速递》2026